mercredi 9 janvier 2013

La tête dans les nuages, les pieds dans les arbres


Nous nous sommes lancés dans la création d'arbre à l'aide du TreeCloud en partant de nos fichiers Contextes Globaux. Pour cela avons utilisé le TreeCloud (http://www2.lirmm.fr/~gambette/treecloud/NuageArbore.cgi) en ligne dans lequel nous avons rentré notre texte (contexteglobal) que le logiciel a "nettoyé" pour ensuite créer un arbre qui représente les mots la  proximité des mots.
Voici le résultat obtenu pour l'anglais :


Un problème est survenu avec les contextes de l'arabe, il semble que TreeCloud ne reconnaisse pas l'arabe...

Notre deuxième fut de faire les nuages de mots, pour cela nous avons utilisé WORDLE : http://www.wordle.net/ . Il suffit d'entrer notre texte (contexte globale) dans la partie "create" et la logicile nous donne un beau nuage de mot ( les plus fréquents dans notre texte. Nous avons éliminé le mot Kadhafi qui était sur-représenté afin de pouvoir mieux observer son entourage sémantique.
Voici un exemple du résultat en arabe :


La fin approche les amis!!! Prochaine étape : création du site internet .
A bientôt pour de nouvelles aventures


Script final des tableaux


Les bras cassés approchent enfin de la ligne d'arrivée ! Notre script des tableaux est terminée et fonctionne correctement sous linux avec la dernière proposition présentée ici même (Miracle : Une seule condition If!!! )


et voilà le résultat :


Exemple du contexte en arabe :


Comme on peut le voir sur cette image, nous avons utilisé une seule expression régulière qui prenne en compte à la fois l'anglais, le français et l'arabe. Le motif choisi est Kadhafi afin de voir ce qui ressort dans les différents articles publiés après sa mort, dans les trois langues.


A suivre : Nuages et arbres!!

lundi 7 janvier 2013

PROBLEME AVEC L'OPTION DUMP

Quand nous lançons notre script, un message d'erreur apparaît au moment du traitement de certains fichiers DUMP par le programme miniegrepmultilingue :

Comme on le voit sur cette capture d'écran, le fichier dump3-2-UTF-8.txt contient trois caractères qui posent problème au miniegrepmultilingue, comme par exemple :

utf8 "\xC3" does not map to Unicode at minigrepmultilingue-v2.2-regexp/minigrepmultilingue.pl line 86.

Cela ne se produit par exemple pas avec le fichier suivant dump3-3-UTF-8.txt.

Quand on ouvre le fichier dump3-2-UTF-8.txt avec notre navigateur, on aperçoit rapidement les caractères qui posent problème puisqu'ils sont représentés par une icône avec un point d'interrogation. Voici les trois contextes :


On devine qu'il s'agit à chaque fois du caractère "à" positionné en fin de ligne !

Nous n'avons pas encore trouvé d'explication certaine, mais lorsqu'on examine ce fichier de plus près grâce à un éditeur hexadécimal, on observe la chose suivante :


En Unicode, le caractère "à" est encodé sur deux octets C3 A0. Or chaque ligne semble se terminer par l'octet A0 puis recommence avec la suite d'octet 20 20 20 20 20 20 20. A0 correspond d'après le tableau des caractères Unicode à un "non-breaking space" et 20 à un espace...

Si on ajoute une nouvelle option à lynx comme -nomargins par exemple, on aura toujours le même problème dès lors qu'un "à" se trouvera en fin de ligne. Par exemple pour le fichier dump3-2-UTF-8.txt on a obtenu avec cette nouvelle option les deux erreurs suivantes :


On peut préciser que dans l'exemple que nous donnons la page web d'origine est déjà encodée en UTF-8. Quand on fait une commande lynx sans dump, tout s'affiche correctement dans via le terminal :

L'erreur semble donc bien provenir de la mise en page effectuée par le dump...

vendredi 4 janvier 2013

DUMP EN UTF-8 AVEC LYNX (partie 1)

Nous allons présenté aujourd'hui une proposition alternative afin de traiter les problèmes d'encodage et de conversion en UTF-8. Il s'agit en gros d'ajouter une option à la commande lynx afin d'obtenir un dump directement en UTF-8 et donc de supprimer une bonne partie des conditions if et des boucles de notre script...

Afin de régler les problèmes d'encodage que nous rencontrions depuis le début, nous avons fait toute une série de tests à partir de fichier html encodé en :

- ASCII
- UTF-8
- ISO-8859-1
- MacRoman
- Windows-1256

On a d'abord constaté que des navigateurs comme Safari et Lynx n'affichaient pas toujours les caractères de ces pages web de la même manière. Il arrive fréquemment que Lynx n'affiche pas ou mal certains caractères non ASCII.

Voici un exemple avec une petite page HTML encodée en ISO-8859-1 :

D'après cette capture d'écran, on voit bien que le fichier est encodé en ISO-8859-1 et que cette encodage est correctement indiqué dans la balise <meta> du code HTML. Pour notre test, on a inséré en plus des caractères accentués leur équivalent en caractère spéciaux HTML. Ce document est donc valide et s'affiche comme ceci dans notre navigateur Safari :


On ne constate aucun problème d'affichage contrairement à Lynx où après avoir tapé la commande lynx suivi du nom de notre fichier HTML on obtient le résultat suivant :


On remarque qu'un espace remplace les caractères accentués, que le "t" de "fête" ne s'affiche pas et que le dernier caractère spéciaux HTML est mal interprété ! On peut préciser que notre shell a pour encodage par défaut UTF-8, mais qu'on obtient le même résultat lorsqu'on sélectionne ISO-8859-1 dans les préférences du terminal. Lorsqu'on fait un dump sur la commande lynx, on obtient un résultat encodé en ISO-8859-1 avec tous les caractères du texte présents. Les caractères spéciaux HTML on bien été remplacés par les caractères correspondants.

Voici les détails en hexadécimal du fichier dump obtenu :


On voit sur cette capture d'écran que le caractère "ê" dans "fête" correspond dans l'écriture hexadécimal à EA, ce qui correspond bien au symbole "ê" dans la table d'encodage ISO-8859-1 :


Tout est bien qui fini bien donc puisque tous les caractères qu'on voyait dans notre navigateur Safari se retrouvent dans notre fichier dump dans l'encodage d'origine.

Mais voyons maintenant ce qui se passe avec la même page web encodée en MacRoman...


On voit sur la capture d'écran que l'encodage de la page est bien en Mac OS Roman et que cet encodage est indiqué correctement dans la balise <meta> du code source. Ce fichier est donc valide et peut être correctement interprété par le navigateur Safari :


On a également vérifié l'encodage de ce fichier HTML à travers sa représentation en notation hexadécimale :


On voit que le caractère "ê" de "fête" correspond en hexadécimal à 90, ce qu'on retrouve bien dans la table d'encodage de MacRoman :


Voici maintenant le résultat obtenu avec le navigateur Lynx :

On constate les mêmes problèmes d'affichage que lors de notre test sur la page HTML encodé en ISO-8859-1...

Et voici les détails en hexadécimal du fichier dump obtenu par la commande lynx -dump MacRoman-meta.html > dump-MAC.txt :


On remarque que le caractère "ê" de "fête" correspond en hexadécimal à EA et non à 90. On peut donc en déduire que le fichier dump obtenu est encodé en ISO-8859-1 et non en MacRoman comme la page web d'origine ! Dans ce cas, on ne peut donc plus se baser sur l'encodage de la page web d'origine pour convertir le fichier dump en UTF-8...

En essayant de mieux comprendre comment fonctionnait Lynx, nous sommes tombés dans le man de cette commande sur une option très intréssante concernant les problèmes d'encodage :


-display_charset=MIMEname
              set the charset for the terminal output.

Nous avons alors fait quelques tests en donnant UTF-8 comme encodage pour l'output et voici quelques-uns de nos résultats.

Avec la commande lynx -display_charset=UTF-8 suivie du nom du fichier de la page HTML encodée en ISO-8859-1 on obtient le résultat suivant :


On voit que cette fois-ci tous les caractères s'affichent correctement. C'est aussi le cas avec le fichier encodé en MacRoman :


On a alors vérifié à travers la représentation en hexadécimal dans quel encodage étaient les fichiers dump produits à partir de la commande lynx -display_charset=UTF-8 -dump sur ces pages web en ISO-8859-1 et MacRoman. Le résultat est identique dans les deux cas :


On remarque que le caractère "ê" de "fête" est encodé sur deux octects C3 AA qui correspondent bien à "ê" dans la table de l'UTF-8 :


Pour résumer, on peut donc penser que l'ajoute de l'option -display_charset=UTF-8 à la commande lynx -dump permettrait d'obtenir un fichier texte encodé en UTF-8 quelque soit l'encodage de la page web d'origine. En tout cas, les tests que nous sommes en train de faire sur l'arabe ont l'air d'aller dans ce sens à condition que le terminal dans lequel on travaille ait pour encodage par défaut UTF-8.

Par conséquent, cette nouvelle option nous permettrait de réduire le nombre de conditions et de boucles dans notre script actuel : un bon coup de défrisage pour la nouvelle année  !!!

dimanche 16 décembre 2012

PROBLEME: "iconv: (stdin):8:8: cannot convert"

Quand nous lançons notre script pour créer un tableau contenant les adresses URLS, les pages aspirées, les DUMPs initiaux et les DUMPs en UFT-8, un message d'erreur de ce type s'affiche parfois dans le terminal :

iconv: (stdin):8:8: cannot convert


Cela signifie que bien qu'on ait indiqué à la commande iconv des encodages apparenant à sa bibliothèque, certains caractères posent encore problème au moment de la conversion !

Nous avons cherché à savoir quelle était l'origine de ce problème et comment il pouvait être résolu dans notre chaîne de traitement...


Voici une capture d'écran du message d'erreur dans le terminal au moment où nous lançons le script4 (fichier disponible dans un précédent) :


Et voici maintenant les images des fichiers produits à partir de cette URL qui pose problème :

Le code source de la page aspirée :


Le fichier DUMP initial :


Le fichier DUMP converti en UTF-8 :

On peut déduire en comparant le fichier DUMP initial et le fichier DUMP en UTF-8 que c'est le caractère É (é majuscule) qui pose problème. La commande iconv interrompt la conversion du DUMP initial en UTF-8 au moment où elle rencontre ce caractère. On se retrouve alors avec un fichier DUMP en UTF-8 incomplet !

Mais comment se fait-il que iconv ne puisse pas convertir le caractère É en UTF-8 ? Pour comprendre cela il faut comparer le code source de la page HTML aspirée et le DUMP intial.
Dans le code source HTML, ce caractère est codé au moyen de l'entité de caractère &#201; que Lynx interprète correctement comme É et qu'on retrouve donc ensuite tel quel dans le fichier
DUMP :

    extrait du code html : 

    résultat dans le DUMP :


Cela a pour principale conséquence que la commande file identifie l'encodage de la page aspirée comme étant en ASCII (puisque tous les caractères accentués qui s'affichent dans le navigateur sont eux même codés au moyen de caractères ASCII selon le prinicpe des entités de caractère). Lynx étant lui même un navigateur, les entités de caractère sont remplacés dans le fichier DUMP obtenu par les caractères correspondants. L'encodage du fichier DUMP ne peut donc pas être en ASCII s'il contient des caractères accentués.

Or voici dans notre script les différentes étapes que nous suivons pour convertir le DUMP initial en UTF-8 :

- On capture la page web avec la commande curl
- On utilise la commande file sur la page aspirée pour détecter son encodage
- Si l'encodage identifié par la commande file n'est pas en UTF-8, alors on cherche si cet encodage appartient à la bibliothèque de iconv
- Si c'est la cas, on dump la page aspirée avec Lynx et on converti ce dump en UTF-8 en indiquant dans les options de la commande iconv l'encodage de départ (=celui de la page web aspirée) et l'encodage de sortie (UTF-8).

Cette procédure ne peut donc plus fonctionner correctement dans le cas qu'on vient de présenter puisque l'encodage identifié par la commande file pour la page aspirée ne correspond pas à celui du DUMP. Pour que la commande iconv fonctionne correctement, il faudrait donc plutôt lui indiquer l'encodage du fichier DUMP au lieu de donner celui de la page aspirée.

Pour cela, nous allons donc devoir revoir notre chaîne de traitement en créant le fichier DUMP plus tôt...

Voici ce que nous proposons dans le cas où la commande file identifie un encodage de la page aspirée différent de UTF-8 :

- on crée le fichier DUMP de la page aspirée
- on détecte l'encodage du fichier DUMP grâce à la commande file ($encodageDump)
- si l'encodage détecté appartient à la bibliothèque de iconv, on convertit le fichier DUMP en UTF-8 et on crée une nouvelle ligne dans le tableau contenant les liens vers l'adresse URL, le fichier HTML aspiré, le fichier DUMP initial et le fichier DUMP en UTF-8. Pour bien se repérer, on indique aussi dans le tableau l'encodage détecté par la commande file pour la page aspirée et le DUMP. (Pour ça, on utilise deux variables : $encodage et $encodageDump)
- si l'encodage détecté au moyen de la commande file n'appartient pas à la bibliothèque de iconv, on cherche au moyen de la commande egrep un encodage dans les balises HTML de la page aspirée
- si on trouve un encodage et qu'il appartient à la liste des encodages disponibles avec iconv alors on crée une nouvelle ligne dans le tableau. On pourrait avoir à cette étape des erreurs avec iconv si l'encodage récupérer dans la balise <meta> ne correspond pas tout à fait à l'encodage réél du document html, mais on laisse tomber ce cas pour l'instant !
- si aucun encodage n'est reconnu, on créé quand-même une nouvelle ligne dans le tableau avec le fichier DUMP initial, mais on ajoute la mention "(encodage inconnu)" et on ne lance aucune convertion en UTF-8.

Voici une capture d'écran de la partie que nous avons modifié dans notre script :


Et voici les résultats :

- plus de message d'erreur dans le terminal :


- le fichier DUMP-UTF-8 qui posait problème est maintenant complet et tous les caractères s'affichent correctement :

- les tableaux produits sur un test avec quelques URLs seulement :


On voit bien dans le tableau 1 les différents encodages reconnus par la commande file dans le cas où un web master à utiliser des entités de caractère...

mercredi 5 décembre 2012

EXPRESSIONS REGULIERES

Lorsque la commande file ne permet pas de récupérer l'encodage d'une page aspirée, nous avons utilisé la fonction egrep.

Dans l'entête d'une page HTML, l'encodage est normalement indiqué dans la balise <meta>, par exemple :


<meta charset="UTF-8" />
 
Le problème est qu'il existe des différences dans la rédaction de cette balise en fonction des créateurs de la page. On peut trouver les cas suivants :
 
<meta charset = UTF-8 /> 
<meta charset='UTF-8' /> 
<meta charset=UTF-8 /> 
<meta charset="UTF-8"> 
 
Sans compter les différences entre HTML-6 et HTML-7 :
 
<meta http-equiv="content-type" content="text/html; charset=iso-8859-1" />  
 
Pour extraire le nom de l'encodage avec la fonction egrep, nous allons donc devoir utiliser une expression régulière prenant en compte tous ces cas :
 
 "charset *= *['\"]?[^\"]+['\"]? */?>" 
 
Cette expression régulière permet de désigner une chaîne de caractères : 
 
- commencant par charset 
- suivi ou non d'un nombre d'espace indéterminé
- puis du signe égal et d'un nombre d'espace indéterminé
- puis de guillemets simples ou doubles ou rien
- puis n'importe quel caractère à part \" (c'est à dire le nom de l'encodage : UTF-8, ASCII, ISO...)
- puis de guillemets simples ou doubles ou rien
- puis d'un espace ou non
- puis un / ou non
- puis une fermeture de balise 

Voici comment on peut intégrer cette expression régulière dans la commande egrep :
 
egrep -i -o "charset *= *['\"]?[^\"]+['\"]? */?>" test.txt; 
 
Pour ne garder que le nom de l'encodage, on utilisera plusieurs fois la fonction egrep et la fonction cut :

encodage=$(egrep -i -o "charset *= *['\"]?[^\"]+['\"]? */?>" ../test.txt | cut -f2 -d\");
echo "L'encodage récupéré dans la page HTML est $encodage";
 
On pourra maintenant ajouter ce code dans une des boucles de notre script pour traiter les cas ou l'encodage n'est pas détecté par la commande file. 

samedi 24 novembre 2012

SCRIPT 4 : URLS - PAGES ASPIREES - DUMPS - UTF-8

Voici venue l'heure de mettre à profit tous les tests effectués précédement pour créer un programme qui génère à partir d'un dossier contenant plusieurs fichier d'URLs un tableau à 5 colonnes avec :

1-Le numéro de l'URL
2-Le liens vers l'adresse URL
3-Le lien vers la page web aspirée
4-Le lien vers le texte extrait de la page web aspirée
5-Le lien vers le texte au format UTF-8 extrait de la page web aspirée

En plus de créer des liens, nous devons donc gérer la capture de pages web, l'extraction de contenu textuel, la reconnaissance et la convertion d'encodage. Tout un programme !!!

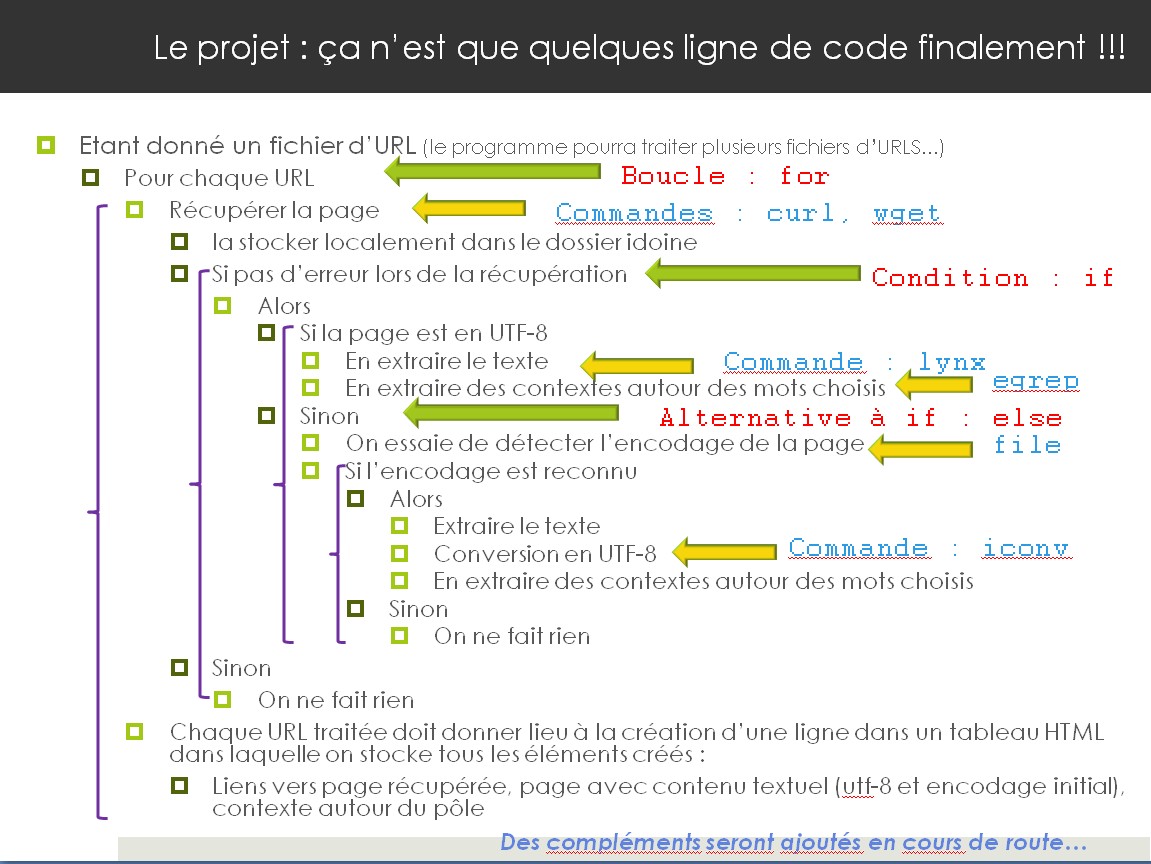
Pour mettre au point notre script, nous nous sommes appuyés sur le schéma présenté sur le site du cours à l'adresse suivante:


Pour chaque boucle nous n'avons fait que reprendre et adapter des portions de script vus précédemment.

Afin débugger plus facilement le programme, nous avons ajouté pas mal de commentaires dans le script et nous avons tirer profit au maximum de la commande echo pour suivre le déroulement du programme dans le terminal.

Vous pouvez télécharger notre nouveau script à l'adresse suivante :


Comme vous verrez, nous en avons aussi profité pour arranger un tout petit peu la présentation des tableaux.

Voici des caputres d'écran faites après un test sur quelques URLs seulement :

Tableaux pour 2 fichiers contenant 3 URLS

Vue du terminal pendant l'execution du script


Normalement, nous avons réussi à régler la plupart des problèmes. On constate juste un type d'erreur dans le terminal au moment de converstion d'encodage avec la commande iconv. On trouve par exemple :

iconv: (stdin):8:8: cannot convert

Pourtant, tous les fichiers présentés dans la dernière colonne du tableau semblent avoir été convertis en UTF-8 ?

Il faudra donc éclaircir ce problème un autre jour... ou une autre nuit ;°) !

Parmi les améliorations possibles, on pourra encore :

- améliorer l'organisation des fichiers produits en output
- améliorer la présentation des tableaux
- ajouter une colonne aux tableaux pour les messages d'erreur (type: CURL, Erreur 404, encodage non reconnu...)
- prendre en compte plus d'erreurs que l'erreur 404 

RECUPERER ET CONVERTIR L'ENCODAGE D'UN FICHIER

Nous avons vu que pour récupérer l'encodage d'un fichier dans une variable, on pouvait utiliser la commande file avec ses options -I et -d suivie de la commande cut et de ses options -d et -f.

En bash, il est également possible de convertir le format d'encodage d'un fichier à condition de préciser dans les options de la fonction iconv l'encodage d'entrée (-f) et l'encodage de sortie (-t).

Voici un exemple à partir d'un fichier texte encodé en ISO-8859-1. On veut convertir son encodage en UTF-8. On peut donc saisir la commande suivante dans le terminal :

iconv -f iso-8859-1 -t utf-8 < kamikaz.txt > kamikaz-UTF-8.txt

Rappel : "<" signifie qu'on donne en entrée le fichier kamikaz.txt et ">" qu'on veut obtenir en sortie le fichier kamikaz-UTF-8.txt

Il existe beaucoup de formats d'encodage différents et pour obtenir la liste de ceux disponibles depuis le terminal, on peut saisir la commande iconv -l. Les conversions ne sont possibles qu'entre des types d'encodage apparenant à cette liste.

Grâce à la fonction egrep, on va donc pouvoir tester si l'encodage d'un fichier appartient à la liste disponible depuis le terminal. 

Voici une proposition de script :

#!/bin/bash
echo "Donnez le nom et l'emplacement du fichier";
read fichier;
encodage=$(file -I $fichier | cut -d= -f2);

detection=$(iconv -l | egrep -i $encodage);

if [[ $detection != "" ]]
then
echo "L'encodage est a été reconnu";
else
echo "L'encodage ne fait pas parti de la liste";
fi


Commentaires: 

- La commande file -I $fichier | cut -d= -f2 permet de récupérer l'encodage du fichier d'entré. On enregistre cette valeur dans la variable encodage.

- La commande iconv -l | egrep -i $encodage permet de rechercher une occurence de la valeur de la variable encodage dans la liste des encodages disponibles. L'option -i permet de ne pas prendre en compte la case. Si cette commande renvoie une valeur, c'est que l'encodage du fichier appartient à la liste des encodages disponibles. On a donc enregistré le résultat de cette commande dans la variable detection afin de pouvoir mettre en place un test sur la valeur de cette variable.

On réutilisera ce type de script dans une des boucles de notre programme traitant nos fichiers d'URLS. Si l'encodage d'une page web aspirée est reconnu, à la place d'afficher le message "L'encodage est a été reconnu", on pourra lancer une convertion avec la commande iconv et les options -f et -t.

CONNAITRE OU VERIFIER L'ENCODAGE D'UN FICHIER

La commande file suivi d'un nom de fichier permet d'afficher son type. On peut y ajouter l'option -i (ou -I sur Mac) pour plus d'informations sur l'encodage.

Voici un exemple sur le fichier texte.txt, contenant uniquement du texte :

file -I fichier.txt;


et voici la réponse dans le terminal :


fichier.txt: text/plain; charset=utf-8


A l'aide de la fonction cut et des options -d (qui permet de définir un délimitateur) et -f (qui permet de définir la zone à selectionner en fonction de ce délimitateur), on va pouvoir extraire de l'information obtenue par la commande file l'encodage d'un fichier.

En reprenant l'exemple ci-dessus, on saisira la commande :

file -I fichier.txt | cut -d= -f2

(Attention, sur PC il faudra peut-être remplacer -I par -i et | par ¦ )

Cette commande indique qu'on choisi comme délimitateur le symbole "=" qui sépare ici notre chaîne de caractère en deux parties :

fichier.txt: text/plain; charset     utf-8
           (1)                        (2)

Avec l'option -f2, on ne garde que le contenu de la deuxième partie, c'est à dire utf-8.

On peut capturer la valeur rendue par cette commande dans une variable qu'on appellera encodage :

encodage=$(file -I fichier.txt | cut -d= -f2)

A partir de cette variable, on pourra imaginer un script qui affiche ou test l'encodage d'un fichier. Voici deux petits exemple en bash qui fonctionnent sur Mac :

1) Script pour afficher l'encodage d'un fichier:

#!/bin/bash
echo "Donnez le nom et l'emplacement d'un fichier";
read fichier;
encodage=$(file -I $fichier | cut -d= -f2);
echo "Ce fichier est encodé en $encodage.";

2) Script pour déterminer si un fichier est encodé en UTF-8:

#!/bin/bash
echo "Donnez le nom et l'emplacement du fichier à tester";
read fichier;
encodage=$(file -I $fichier | cut -d= -f2);
if [[ $encodage == "utf-8" ]]
then
echo "Ce fichier est bien encodé en UTF-8.";
else
echo "Ce fichier n'est pas encodé en UTF-8. Il est encodé en $encodage.";
fi

TESTS SUR LA FONCTION CURL

Aujourd'hui, nous allons nous intéresser de plus près aux différents outputs produits par la fonction CURL.

On cherche notemment à détecter les erreurs possibles au moment de l'aspiration d'une page web afin de pouvoir prendre en compte ce facteur dans une des boucles de notre programme de traitement des URLS.

Pour cela, nous avons d'abord testé depuis le terminal différents cas :

    - Erreur de type "pas de connection possible !"
    - Erreur de type "adresse URL non valide !"

A) Erreur de type "pas de connection possible !"

On tape la commande suivante dans le terminal pour aspirer le contenu de la page web du cours :


curl http://www.tal.univ-paris3.fr/cours/masterproj.htm -o page-aspiree.html;


(l'option -o permet d'indiquer le fichier dans lequel sera enregistré le contenu aspiré par CURL)

Si tous se passe bien, le terminal affiche des informations sur l'aspiration de la page :


  % Total    % Received % Xferd  Average Speed   Time    Time     Time  Current
                                 Dload  Upload   Total   Spent    Left  Speed
100 99762  100 99762    0     0  1462k      0 --:--:-- --:--:-- --:--:-- 1709k


En revanche, si CURL rencontre un problème, il produit un message d'erreur. Par exemple, si on coupe notre connexion internet et qu'on reproduit l'expérience, on obtient le message suivant dans le terminal :

curl: (6) Could not resolve host: www.tal.univ-paris3.fr; nodename nor servname provided, or not known

Pour tester dans un script si CURL a fonctionné correctement, on peut donc enregistrer le message produit par CURL dans une variable qu'on appelera retourcurl: 


curl http://www.tal.univ-paris3.fr/cours/masterproj.htm -o page-aspiree.html;

retourcurl=$?;
echo "Voici la réponse de CURL : $retourcurl";


A partir de ce script, on constate donc que si $retourcurl vaut 0 alors, on peut dire que CURL a bien fonctionné. Si $retourcurl vaut 6 (ou une autre valeur?) alors il y a eu un problème. A partir de cela, on peut écrire un petit programme en bash testant cette condition sur un exemple :


#Aspiration d'une page web du cours
curl http://www.tal.univ-paris3.fr/cours/masterproj.htm -o page-aspiree.html;

#Capture du message produit par CURl dans une variable
retourcurl=$?;

#Test sur la valeur de cette variable
if [ $retourcurl == 0 ]
then 
echo "CURL a réussi à aspirer la page WEB.";
else 
echo "CURL a échoué.";
fi


Avec ce script, on obtientera dans le terminal un message nous indiquant si CURL a bien fonctionné sur la page web.

B) Erreur de type "l'adresse URL n'est pas valide !"

Lorsqu'on saisi une adresse URL qui n'est pas valide, le navigateur produit automatiquement un message d'erreur. Avec la commande CURL que nous avons tapé dans le terminal, si l'adresse n'existe plus ou bien qu'elle est incorrecte, on aura donc toujours une page HTML en sortie (affichant l'erreur 404). Du coup, dans notre script précédent, la condition $retourcurl == 0 sera bien remplie alors qu'il y a un problème !

Voici le résultat de la page asspirée lorsqu'on insère une erreur dans l'adresse URL du cours :


Et voici le code HTML de cette page :


Grace à la fonction egrep de bash, on peut donc parcourir le contenu du code HTML de la page aspirée afin d'y chercher une occurence de "Error 404" (caractérisitique d'un message d'erreur de ce type).

egrep -io "Error 404" page.html

(la fonction -i permet de ne pas prendre en compte la case et la fonction -o permet de chercher une occurence)

On va alors enregistrer la valeur produite par la fonction egrep dans une variable pour ensuite voir les valeurs qu'elle peut prendre.


#!/bin/bash
curl http://www.tal.univ-paris3.fr/cours/masterproj.htm -o page-aspiree.html;

error404=$(egrep -io "Error 404" page-aspiree.html);
echo "Voici le retour de la fonction egrep : $error404";


Lorsque l'adresse URL est correcte et que CURL fonctionne correctement, la variable error404 ne contient aucune valeur. Lorsque l'erreur 404 se produit, alors $error404 vaut "Error 404".

Voici un test en bash permettant de vérifier si la page aspriée contient une erreur de type 404 :

#!/bin/bash
curl http://www.tal.univ-paris3.fr/cours/masterpro.htm -o page-aspiree.html;

error404=$(egrep -io "Error 404" page-aspiree.html);

if [[ $error404 == "Error 404" ]]
then 
echo "La page aspirée contient une erreur de type 404.";
else 
echo "La page aspirée est valide.";
fi


Préparation d'un script test sur la fonction CURL

Grâce à ces petites expériences, on peut maintenant proposer un script testant le bon déroulement de l'aspiration d'une page web.

On veut d'abord tester s'il n'y a pas d'erreur de type A puis si c'est le cas, vérifier s'il n'y pas de problème de type B. On a donc le schéma de condition suivant :

Si A ne pose pas problème:
   alors on vérifie si B pose problème:
      si oui, on affiche que A fonctionne mais que B pose problème
      sinon, on affiche que tout fonctionne 
sinon on affiche que A pose problème

Pour mettre en oeuvre cela, on va simplement imbriquer les deux scripts test qu'on vient de présenter.

Voici une capture d'écran de notre nouveau script test :

On pourra maintenant reprendre ce script dans une des boucles de notre programme traitant nos fichiers d'URLS. On pourra aussi améliorer les performances de ce script en prenant en compte d'autres types d'erreurs que l'erreur 404...